Обзор HUAWEI WATCH GT 7 Pro: премиальные материалы, серьезный спорт и до 21 дня без зарядки
Обзор HUAWEI WATCH GT 7 Pro: дизайн, AMOLED 3000 нит, автономность до 21 дня, функции здоровья и спорта, GPS, цены и акции в Беларуси.


Новости Сентябрь 3, 2026
Время чтения: ~3 мин.
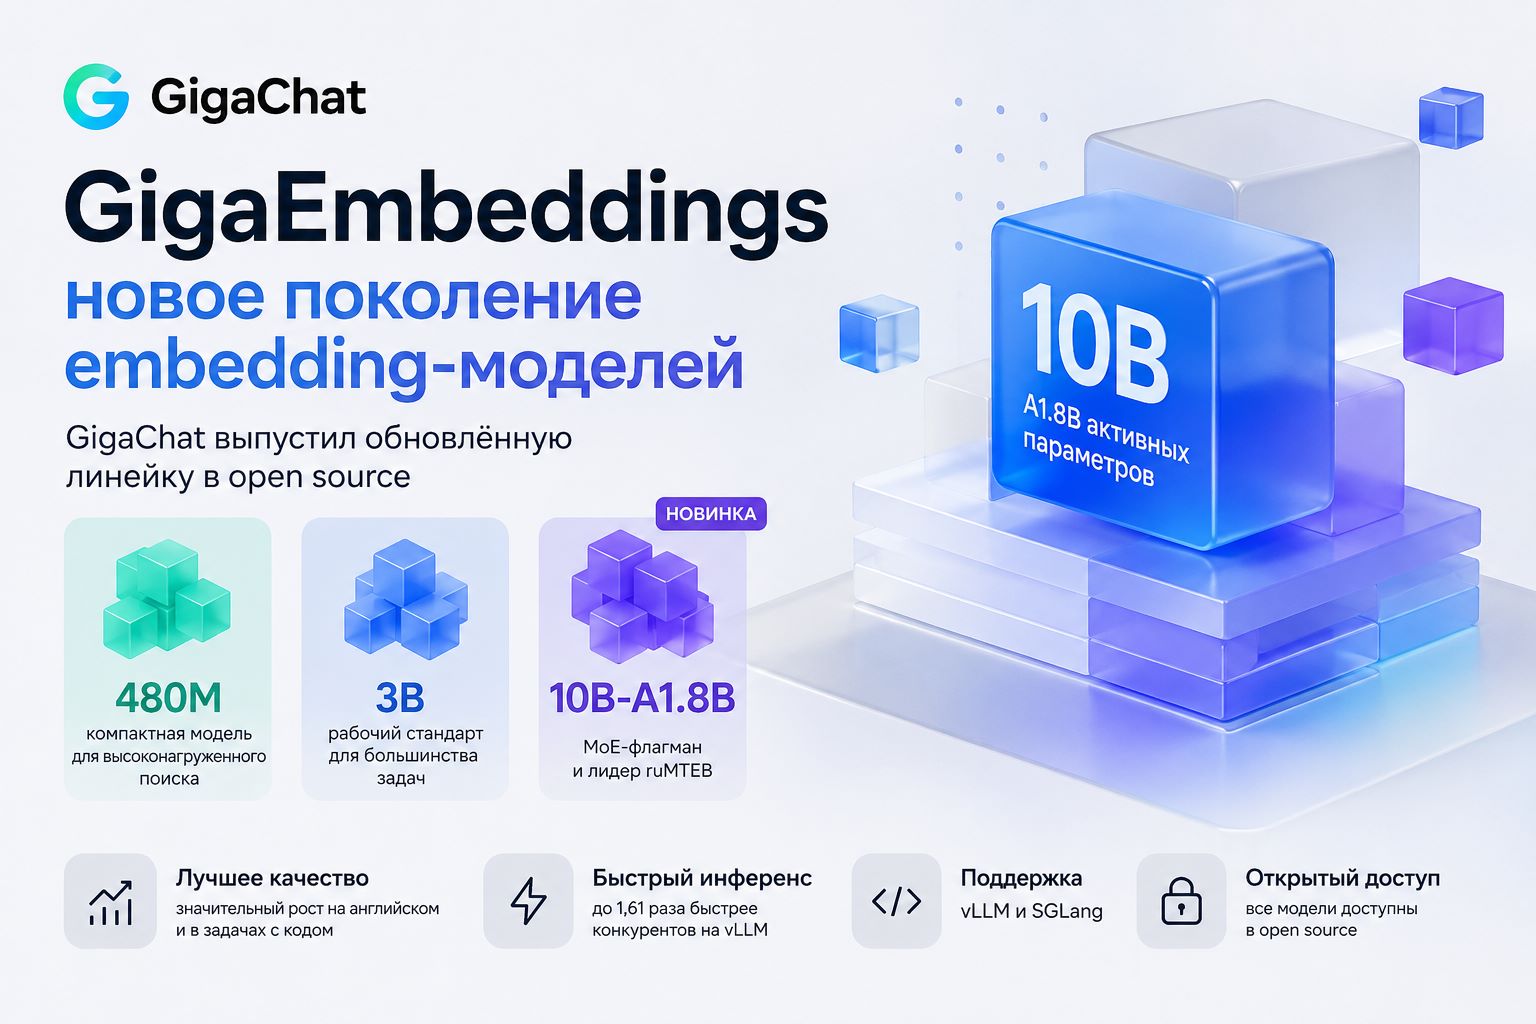
Команда GigaChat представила обновленную линейку моделей GigaEmbeddings, предназначенных для семантического поиска, RAG-систем, классификации и других задач, где текст нужно превратить в качественное векторное представление.
В новой линейке сразу три модели: компактная GigaEmbeddings 480M, более универсальная 3B и новый флагман 10B-A1.8B. Все они опубликованы в открытом доступе, поэтому разработчики могут использовать их в собственных проектах и разворачивать локально.
Самая интересная модель в релизе называется GigaEmbeddings 10B-A1.8B. Это MoE-модель с 10 млрд параметров, из которых во время работы активны только 1,8 млрд.
Такой подход позволяет получить преимущества крупной модели без необходимости постоянно рассчитывать все 10 млрд параметров. По заявлению разработчиков, новый флагман не только показывает более высокое качество по сравнению с GigaEmbeddings 3B, но и оказывается быстрее нее при батчевом инференсе.
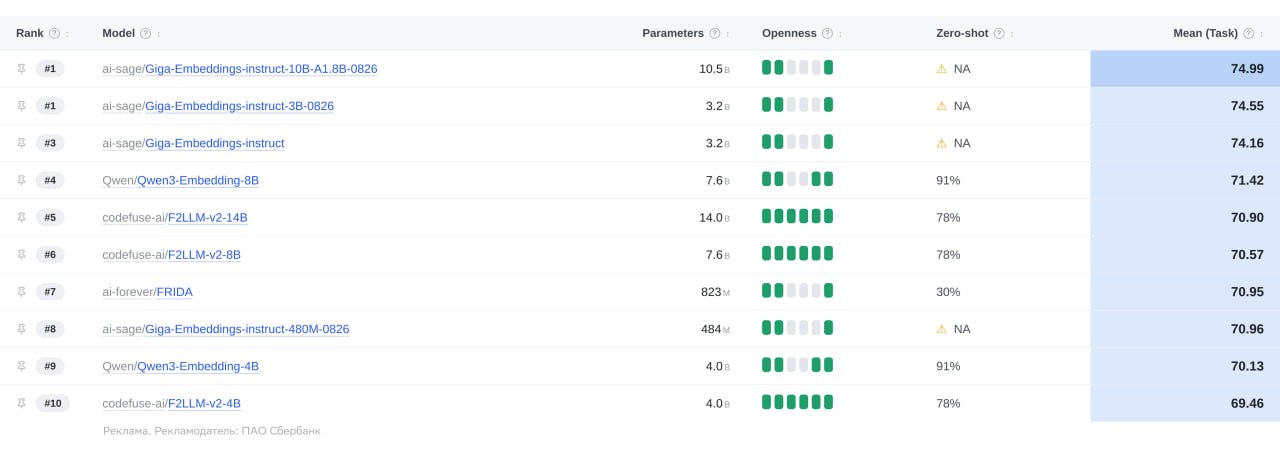
В рейтинге ruMTEB модель заняла первое место среди представленных решений, набрав 74,99 балла на русскоязычных задачах.
При этом заметно улучшились результаты и за пределами русского языка. Особенно сильно разработчики прокачали работу с программным кодом.
В задачах, связанных с кодом, новая GigaEmbeddings 3B получила результат 76,93 балла, тогда как предыдущая версия набирала 62,37.
Флагманская 10B-A1.8B поднялась еще выше, до 78,40 балла. Для разработчиков это особенно интересно, поскольку embedding-модели используются не только для обычного текстового поиска, но и для поиска по исходному коду, документации, базам знаний и большим репозиториям.
Иными словами, GigaEmbeddings постепенно превращается из решения исключительно для русскоязычных текстов в более универсальный инструмент.
Разработчики отдельно поработали над производительностью. При использовании vLLM флагманская модель демонстрирует скорость в 1,44-1,61 раза выше Qwen3 Embedding 4B.
На последовательностях длиной 512 токенов показатель достигает 112,6 тыс. токенов в секунду против 70,1 тыс. у конкурирующей модели. Разница получается довольно заметной, особенно если embedding-инфраструктура работает с большими объемами документов и запросов.
Для production-сценариев это может быть едва ли не важнее нескольких дополнительных баллов в бенчмарках: быстрее обработка батча означает меньше времени и ресурсов на индексацию и поиск.
Кроме vLLM, новая линейка поддерживает SGLang, что расширяет возможности ее использования в современных инфраструктурах для запуска моделей.
Для нового поколения моделей команда увеличила объем обучающих данных на этапах contrastive pretraining и fine-tuning. В обучение добавили, среди прочего, открытые наборы данных Nemotron, F2LLM и KALM.
Отдельная проблема заключалась в том, чтобы улучшение результатов на английском языке и коде не ухудшило качество на русском. Для этого разработчики использовали SLERP-мерджинг моделей, который помог сохранить баланс между языками и разными категориями задач.
Компактную версию 480M дополнительно обучали с помощью дистилляции. В процессе модель училась воспроизводить распределения cosine similarity внутри батча от более сильных моделей через KL divergence.
В результате получилась не просто одна большая модель, а целая линейка под разные сценарии.
480M выглядит наиболее интересным вариантом для систем, где критичны скорость и экономия ресурсов. Ее логично рассматривать для высоконагруженного поиска и задач, где модель должна работать максимально быстро.
3B является своего рода универсальным вариантом. Она заметно сильнее предыдущего поколения и особенно прибавила в работе с кодом, оставаясь при этом более компактной альтернативой флагману.
10B-A1.8B рассчитана на ситуации, где на первом месте стоит качество. Благодаря MoE-архитектуре при 10 млрд общих параметров активная часть составляет всего 1,8 млрд, что позволяет сочетать высокую точность с хорошей производительностью.
Все три модели уже доступны в open source через Hugging Face.
Итог простой: GigaChat явно хочет сделать GigaEmbeddings не локальным решением исключительно для русскоязычных проектов, а полноценной embedding-линейкой для современных AI-систем. Особенно любопытно выглядит 10B-A1.8B: первое место в ruMTEB, заметный рост на задачах с кодом и высокая скорость инференса делают ее довольно серьезным игроком на рынке embedding-моделей.
Обзор HUAWEI WATCH GT 7 Pro: дизайн, AMOLED 3000 нит, автономность до 21 дня, функции здоровья и спорта, GPS, цены и акции в Беларуси.